OpenMOSS 发布开源图像生成模型 MOSS-Image,主打长文本渲染与可编辑布局
MOSS-Image:让开放模型真正理解文字与版式
AI 摘要
OpenMOSS 发布开放权重图像生成模型 MOSS-Image,采用 5B 参数单流 DiT 从零预训练,支持最长 4K token 提示词、中英文长文本渲染和可编辑的 JSON Layout。
正文 · AI 翻译
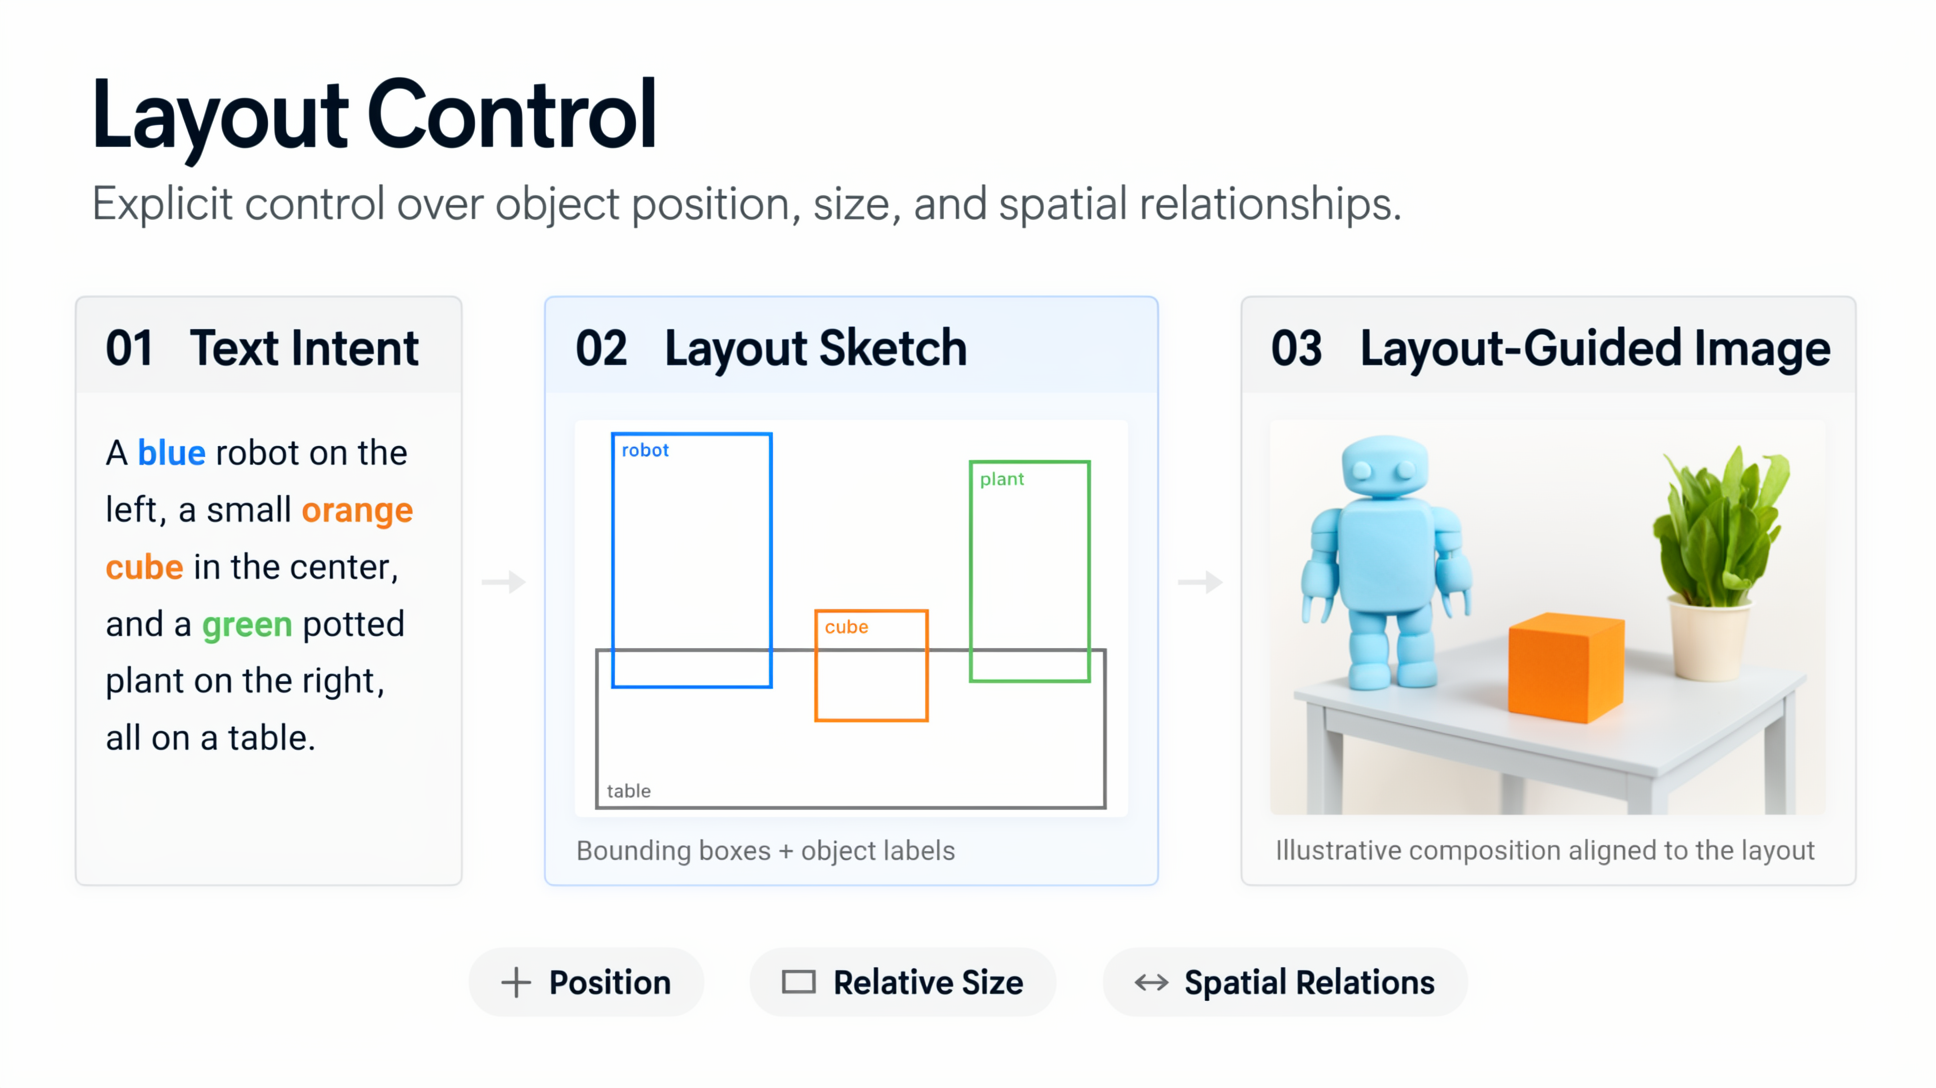
**一句话结论:** MOSS-Image 面向的是图像生成中最难交付的一类任务:海报、信息图、漫画、UI 草图和教学材料里同时出现大量文字与多个有明确位置关系的元素。它以 5B 参数的单流 DiT 为基座,从零开始训练,支持最长约 4K token 的提示词、中文和英文长文本渲染,以及可以直接编辑的 JSON Layout。论文报告显示,它在开放权重模型的长文本评测上达到最高水平;在统一增强提示词后,基座生成器的布局偏好得分也超过了被比较的生成器。
### 5B 单流 DiT
从零预训练的图像生成基座,采用 Muon–AdamW 训练配方,并以统一的文本条件通道处理自然语言和结构化 Layout。
### 长文本渲染
保留换行和段落结构,支持中英文长文本;适合标题、说明、对白、表格和信息密集的视觉材料。
### 可编辑布局
用 JSON 描述画布、文本、对象和边界框,控制位置、大小与空间关系,也便于在生成前反复修改版式。
### 开放生态
Base 与 SFT 权重采用 Apache-2.0,提供 Diffusers、Gradio 和 ComfyUI 路径,并支持 LoRA 与全量微调。
原文
Original Title
MOSS-Image:让开放模型真正理解文字与版式
Source
OpenMOSS / 复旦NLP / 上海创智 / MOSI
Site
openmoss.ai
Published
2026-10-28T16:00:00.000Z